
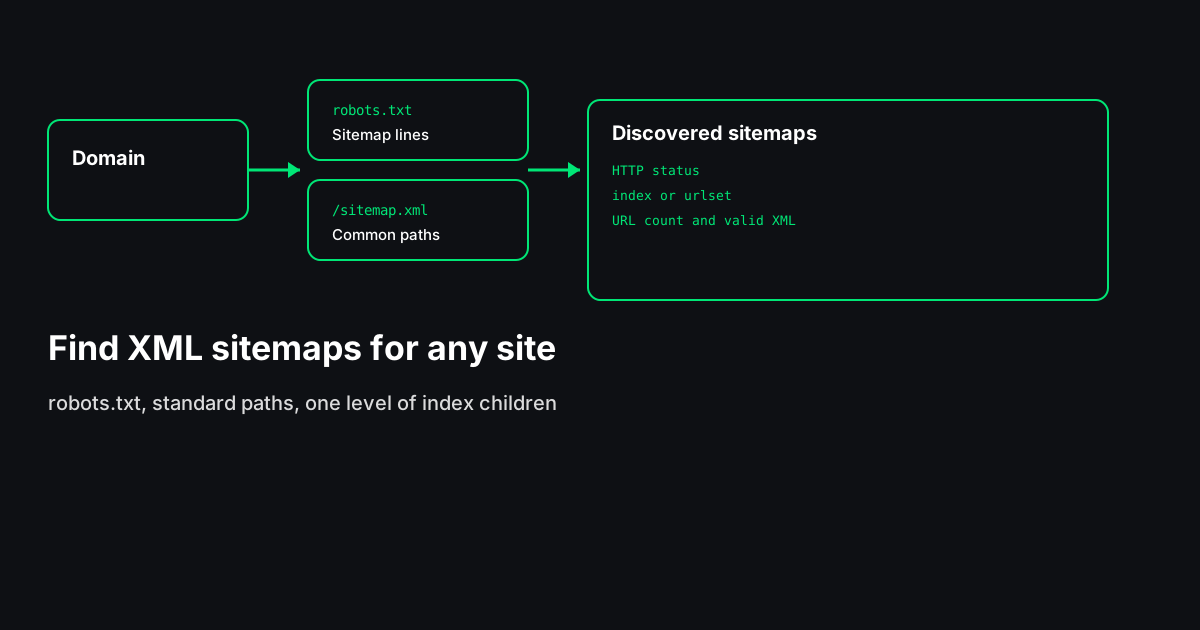
Necesitas el sitemap XML antes de auditar las URLs que contiene, enviar el archivo correcto en Search Console o comparar staging con producción. Adivinar /sitemap.xml funciona en muchas tiendas WordPress o Shopify — hasta que no. El orden fiable es: robots.txt, rutas habituales y luego hijos del índice de sitemap.
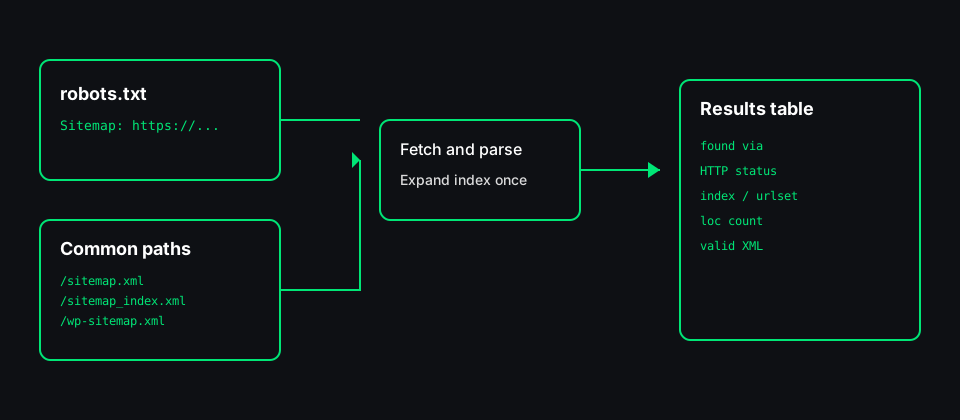
El Buscador de sitemap de Scrawl automatiza esa secuencia desde nuestros servidores: lee líneas Sitemap: en robots.txt, prueba rutas estándar (/sitemap.xml, /sitemap_index.xml, /wp-sitemap.xml y otras) y sigue un nivel de archivos índice. Cada fila muestra la URL, cómo se encontró, estado HTTP, tipo índice o urlset, recuento de <loc> y si el cuerpo parseó como XML de sitemap válido. No comprueba cada URL de página dentro del archivo.
Empieza por robots.txt
Obtén https://tu-dominio/robots.txt y busca líneas como:
Sitemap: https://www.ejemplo.com/sitemap_index.xmlLa documentación de robots.txt de Google trata estas líneas como pistas de descubrimiento. Un sitio puede listar varios sitemaps, incluso en otro host.
Comprobación manual:
curl -s https://www.ejemplo.com/robots.txt | grep -i sitemapSi robots.txt falta o devuelve error, sigue con rutas habituales.
Rutas habituales
| Ruta | Uso típico |
|------|------------|
| /sitemap.xml | Valor por defecto |
| /sitemap_index.xml | Yoast y muchos CMS |
| /sitemap-index.xml | Variante con guion |
| /wp-sitemap.xml | WordPress core |
| /post-sitemap.xml | Urlsets divididos |
| /page-sitemap.xml | Urlsets divididos |
| /sitemap/sitemap.xml | Carpeta anidada |
| /sitemap.xml.gz | Sitemap comprimido |
Un 404 en una ruta no significa que no haya sitemap en otra.
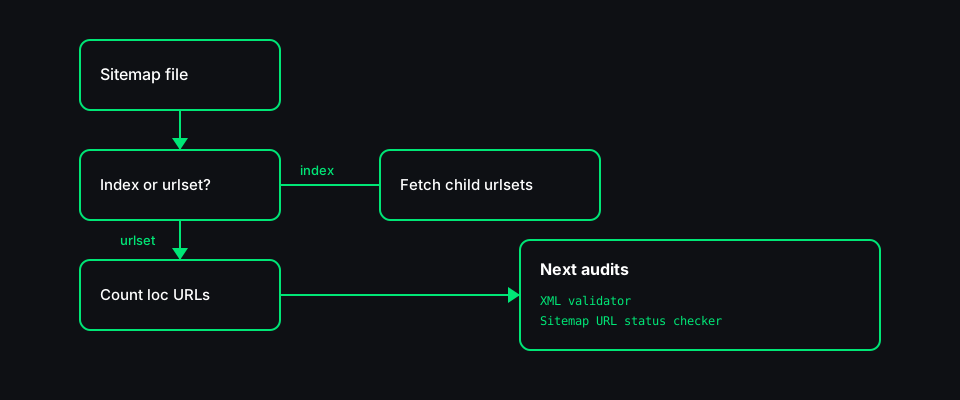
Índice de sitemap frente a urlset
- `<sitemapindex>` — lista otros archivos sitemap.
- `<urlset>` — lista URLs de página.
Con un índice, suele bastar un nivel de expansión: obtén el índice y luego cada urlset hijo.
Después de encontrar el sitemap
| Objetivo | Siguiente paso |
|----------|----------------|
| Sintaxis XML | Validador de sitemap XML |
| Estado de URLs listadas | Comprobador de errores del sitemap |
| Reglas robots.txt | Tester de robots.txt |
| Lista masiva de Search Console | Comprobador masivo de estado HTTP |
Límites honestos
- Autenticación — Sitemaps tras login pueden no ser visibles.
- JavaScript — Sitemaps solo generados en el navegador no aparecen en peticiones HTTP estáticas.
- Otros orígenes — robots.txt puede apuntar a otro host alcanzable y seguro.
- Alcance — Encontrar el archivo no prueba que cada
<loc>devuelva 200.
Pega un dominio en el Buscador de sitemap, exporta la tabla si necesitas registro, y pasa a validación y auditorías por URL.