

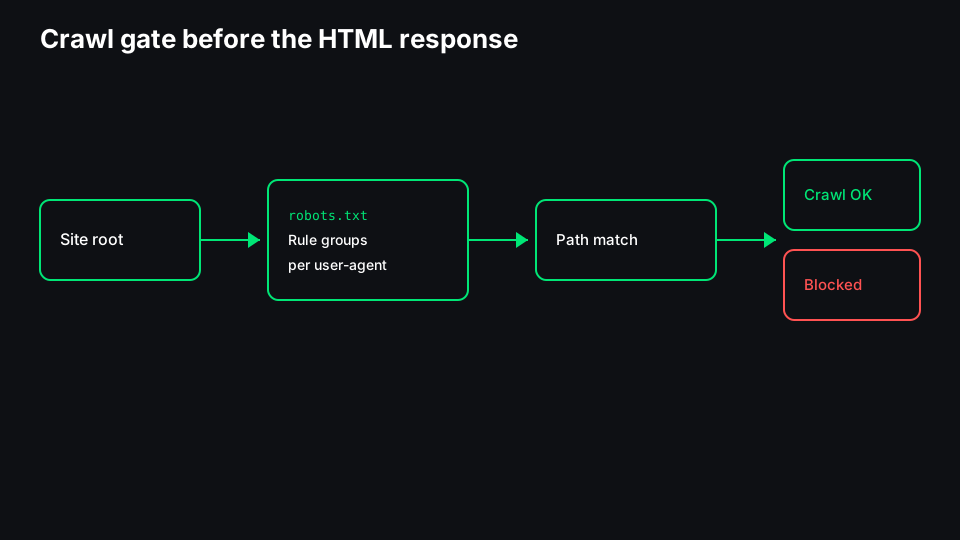
Robots.txt es un archivo de texto en la raíz que dice a los rastreadores qué rutas pueden obtener. Es una puerta de rastreo, no un mando a distancia del índice. Google puede mostrar una URL en resultados —a veces sin descripción— si otros sitios enlazan a ella, aunque robots.txt bloquee a Googlebot.
Esa confusión arruina más migraciones que un 301 mal puesto. Equipos hacen Disallow en staging para «ocultar» y luego preguntan por qué Search Console sigue listando esas URLs. O dejan todo rastreable y esperan que un noindex dentro de HTML bloqueado funcione: no puede, porque Googlebot no ve la etiqueta.
Esta guía explica Allow, Disallow y comodines, la diferencia entre rastreo e indexación, errores frecuentes, user-agents de IA y un flujo de pruebas. Cuando necesites pegar un archivo y probar rutas, usa el Tester de robots.txt con el user-agent que te importe.
Rastreo frente a indexación
Rastrear es pedir una URL y recibir respuesta. Indexar es que el buscador guarde esa URL y pueda mostrarla. Robots.txt solo afecta al primer paso en bots que obedecen el archivo.
| Señal | Qué controla | Dónde suele estar |
|--------|----------------|-------------------|
| Disallow en robots.txt | Si el bot puede obtener la URL | /robots.txt |
| noindex | Si debe aparecer en búsqueda | meta HTML o cabecera X-Robots-Tag |
| Canónica | URL preferida ante duplicados | enlace o cabecera |
| HTTP 404 / 410 | La URL ya no existe | respuesta del servidor |
La documentación de Google es clara: bloquear con robots.txt no sustituye a noindex si quieres quitar URLs de búsqueda. Si haces Disallow, Googlebot puede no rastrear y nunca ver un noindex en esa URL.
Allow, Disallow y grupos User-agent
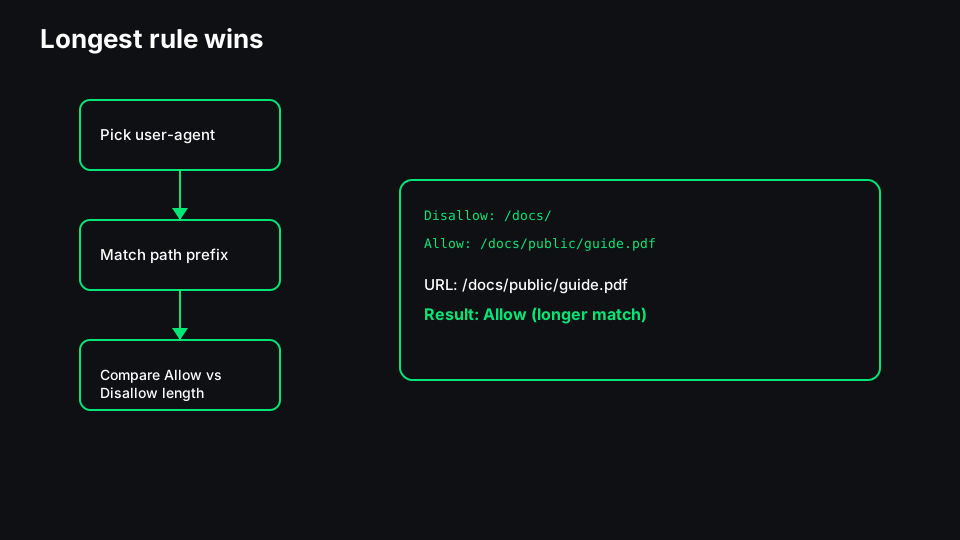
Robots.txt va por líneas. User-agent abre un grupo; las líneas Allow y Disallow siguientes aplican a ese bot hasta el siguiente User-agent.
La coincidencia usa la ruta de la URL. Disallow: /blog bloquea /blog y /blog/articulo-1 por prefijo, salvo que uses $.
Allow dentro de Disallow: gana la regla coincidente más larga. Así desbloqueas un PDF dentro de una carpeta bloqueada.
User-agent: * es el grupo por defecto. No asumas que una línea bloquea a todos los bots del mundo.
Comodines: * y $
Google admite:
- *``** — cualquier secuencia en la ruta.
- `$` — ancla al final de la ruta.
Ejemplos: Disallow: /*.pdf$ bloquea rutas que terminan en .pdf; Disallow: /search/* bloquea todo bajo /search/.
Los comodines se abusan con facilidad. Prefiere reglas de prefijo claras en /cart/ o /account/ y prueba con URLs reales.
El mito del noindex
Tres patrones se repiten:
- «Disallow y desaparece de Google». Reduce rastreo; no pide baja del índice.
- «Pondremos noindex en robots.txt». No existe; va en HTML o cabeceras visibles al bot.
- Bloquear CSS/JS para ahorrar rastreo. Suele empeorar el renderizado.
Primero decide intención de índice, luego reglas de rastreo que dejen ver las etiquetas que necesitas.
Errores habituales
- Barra final distinta entre
/apiy/api/. - Copiar
Disallow: /de staging a producción. - Olvidar que cada subdominio tiene su propio robots.txt.
- Sitemap con URLs bloqueadas por Disallow.
- Intentar bloquear parámetros solo con robots.txt; mejor canónicas y redirecciones.
- Bloquear un user-agent de IA y dejar abierto el que usa otro producto.
User-agents de rastreadores de IA
Bots de productos de IA suelen traer un User-agent propio. Puedes añadir grupos para GPTBot, ClaudeBot, PerplexityBot, etc.
Google-Extended no es Googlebot. Bloquear uno no bloquea el rastreo de búsqueda normal.
Robots.txt es voluntario. Para contenido sensible usa autenticación.
Flujo de pruebas
- Copia el robots.txt en vivo desde
https://tusitio.com/robots.txt. - Lista URLs que deben seguir rastreables y las que no.
- Prueba rutas con un tester que muestre la regla ganadora. El Tester de robots.txt sirve para ese ciclo pegar-y-probar.
- Publica y pide un fetch nuevo en Search Console.
- Inspección de URLs en plantillas críticas.
- Vuelve a revisar tras cambios de rutas o idiomas (
/es/).
Cuándo robots.txt no es la herramienta
Autenticación para zonas privadas. noindex para URLs de poco valor que quieras rastrear. 404/410 para contenido eliminado. Canónicas para duplicados.
Robots.txt brilla para ahorro de rastreo intencional —navegación facetada, archivos infinitos, resultados de búsqueda interna— no para arreglar deuda de índice bloqueando todo.
Mantén el archivo aburrido: unos Disallow precisos, Allow donde haga falta y una línea Sitemap: al índice real. Los archivos aburridos se rompen menos que los puzzles de comodines.